“拆一只开源鸭子”系列:(一)硬件、软件和部署 · (二)训练原理 · (三)仿真里鸭子为什么不走路 · (四)自己训一遍
前三篇都是读别人的代码。这一篇是自己动手:用官方仓库先训一个走路教师策略(teacher policy),再复现 velstand(走、站、摔倒后爬起一体的策略),最后修掉它慢速前进不走的问题。用到的概念在第二篇《训练原理》里都有解释。
这次训练用的参数
代码是 microduck_rl 的 commit bae39f5。除了最后一行的修复,其余参数都是官方配置,没有改。
| 项目(item) | 配置项(config key) | 取值(value) |
|---|---|---|
| 并行环境(parallel environments) | num_envs |
4096 个 |
| 仿真(simulation)步长 / 控制频率 | timestep、decimation |
5 ms / 50 Hz(每 4 个仿真步做一次决策) |
| 每轮采样 | num_steps_per_env |
每个环境 24 步,共 98,304 步 |
| 每回合最长 | episode_length_s |
20 秒(1000 步) |
| 网络 | hidden_dims、activation、obs_normalization |
Actor 和 Critic 都是三层全连接(fully connected) 512-256-128,ELU 激活,输入先归一化(normalization) |
| PPO | learning_rate、schedule: adaptive、desired_kl、gamma、lam、clip_param、entropy_coef、num_learning_epochs、num_mini_batches |
学习率(learning rate) 1e-3,按 KL 散度(KL divergence)自动调整(目标 0.01);γ 0.99,λ 0.95;裁剪 0.2;熵系数 0.01;每轮数据过 5 遍,分 4 个小批量(mini-batch) |
| 随机种子 | seed |
42 |
| 保存间隔 | save_interval |
每 250 轮 |
| 走路教师策略 | max_iterations |
任务 Mjlab-Velocity-Flat-MicroDuck,从零训练 4000 轮 |
| velstand | max_iterations、MICRODUCK_WARM_START=1、--init-checkpoint |
任务 Mjlab-VelStand-Rough-Backlash-MicroDuck,3000 轮。网络初始参数直接从官方走路锚点(anchor)拷过来,课程(curriculum)从最后一档开始(MICRODUCK_WARM_START=1),这叫热启动(warm start) |
| velstand 的行为克隆(behavior cloning, BC) | bc_cfg:hf_checkpoint、gate_tilt_deg、anchor_hf_checkpoint、anchor_tilt_deg、coef、anchor_coef、learning_rate |
站立教师策略 microduck_stand/69u48n8l_9750,教倾斜超过 35° 的帧;走路锚点 velocity2/441tzs6d_3750,教倾斜小于 25° 的帧。两个系数都是 1.0,单独一个 Adam 优化器(optimizer),学习率 3e-4。两个教师策略都从官方公开的 Hugging Face 仓库下载 |
| 修慢速的继继续训练练(fine-tune) | anchor_lin_remap(补丁新增)、奖励(reward) track_lin_fine(std、weight) |
从第 2999 轮再训 1000 轮。小指令时给走路锚点喂放大的速度(0.10 → 0.22,0.15 → 0.25 m/s),新增一项窄的前进速度跟踪奖励(std 0.12,权重 2.0) |
验证都在电脑上的 CPU 仿真里做:官方的 infer_policy.py,BAM 舵机(servo)模型,带背隙(backlash)的场景。
第一步:训一个走路教师策略
我用官方仓库原样训了一遍走路任务(Mjlab-Velocity-Flat-MicroDuck),4096 个并行环境,4000 轮。
训练曲线
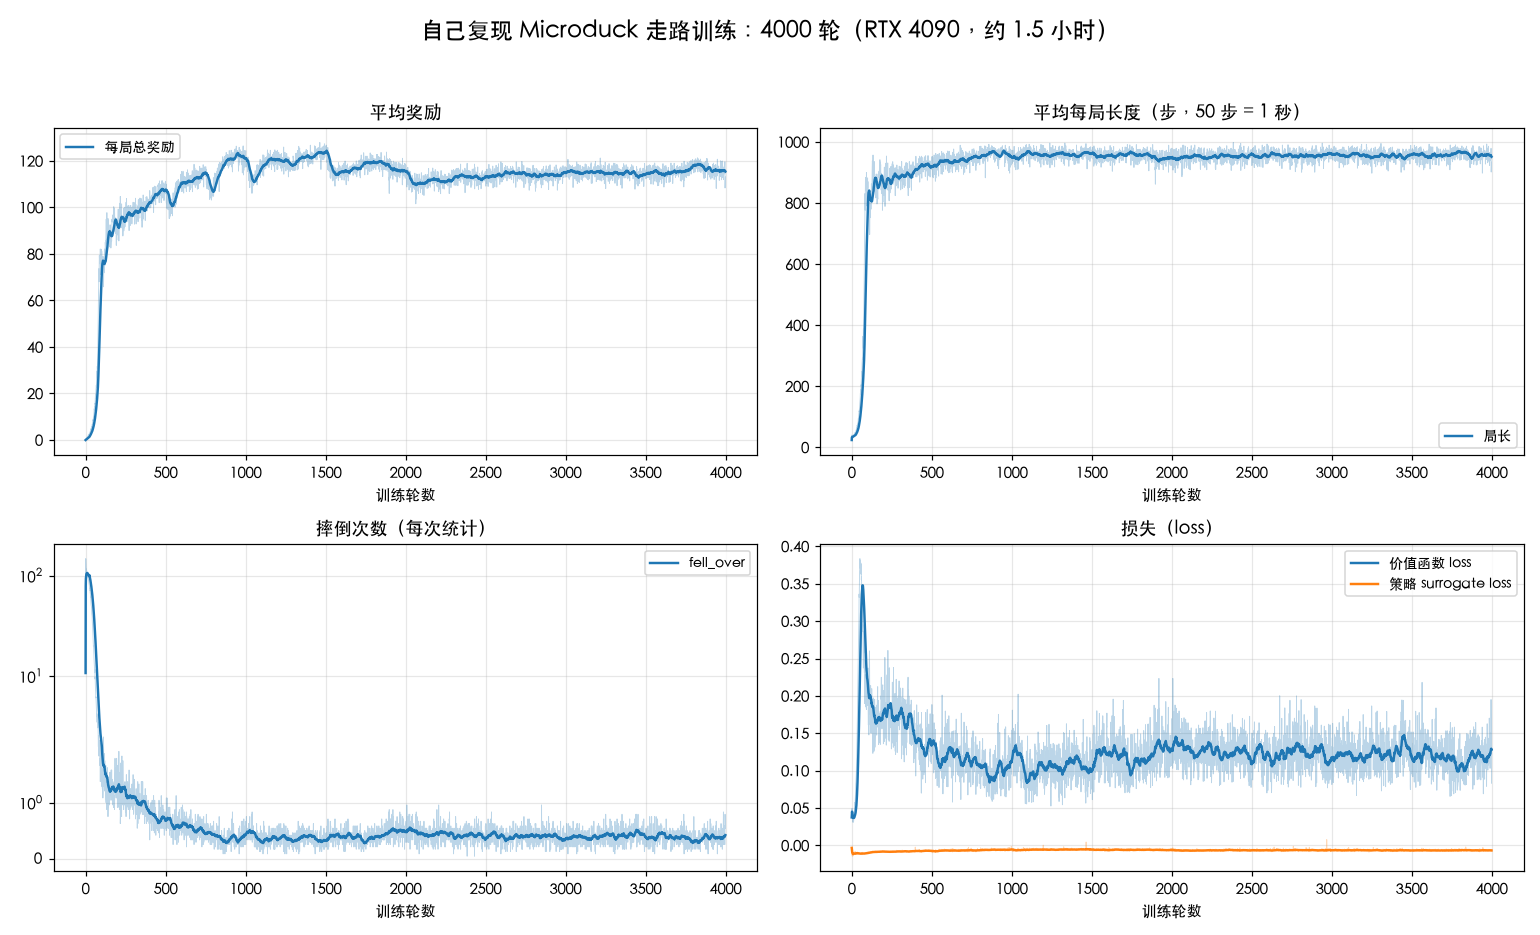
- 前 150 轮最关键。奖励从 0 冲到 80 左右,每回合长度从 36 步涨到 800 多步(一回合最长 1000 步,即 20 秒),摔倒次数从每次统计 100 多次降到 1 次左右。到这里它已经学会不摔了。
- 之后的奖励曲线有几处台阶和回落,都对得上课程表:第 500 到 1500 轮,动作平滑惩罚分五档从 −0.1 加到 −1.0;第 2000 轮,头部转动范围放到最大,同时四分之一的环境改练原地站着。每加一次难度,奖励掉一点,再慢慢爬回来。
- 价值函数(value function)的 loss 在第 70 轮左右冲到 0.35,随后回落到 0.1 上下。前期回报变化太快,评价网络要跟着重学,这一段是正常的。策略(policy)的 surrogate loss 一直贴近 0。
结果
训完导出 ONNX,放回电脑上的 CPU 仿真(官方的 infer_policy.py,BAM 舵机模型)里跑,每种指令 12 秒:
| 指令(command) | 实际表现(result) |
|---|---|
| 站着不动 | 稳稳站住 |
| 前进 0.15 m/s | 站着不动,没有往前走 |
| 前进 0.3 m/s | 往前走,沿身体朝向约 0.13 m/s,但同时以约 0.24 rad/s 往一边偏,走成一段弧线 |
| 原地转 0.8 rad/s | 转起来,约 0.65 rad/s |
所有情况下都没摔。前进速度只有指令的四成左右,还会偏,小指令下干脆不走。拿官方发布的走路策略 alpha_walking.onnx 在同一套回放里对照,表现差不多:0.15 m/s 不走,0.3 m/s 时向前约 0.09 m/s,也往一侧漂。所以我这次算是复现了官方的走路教师策略,包括它的毛病。官方机器人上实际跑的是 velstand,它是在这个走路教师策略的基础上,再用行为克隆和更多课程一代代练出来的。
验证视频
第二步:复现 velstand,顺手修慢速前进
走路教师策略复现完,我接着复现官方机器人上实际跑的 velstand。它把走、站、摔倒后爬起放进同一个策略里。官方的 v8 是分 5 次、在不同分支上一代代训出来的。我简化成一次:从官方公开的走路锚点(Hugging Face 上的 velocity2/441tzs6d_3750)热启动,任务 Mjlab-VelStand-Rough-Backlash-MicroDuck,3000 轮。
和官方 v8 比
两个策略放进同一套 CPU 仿真(带背隙的场景,BAM 舵机模型)里对照:
| 测试(test) | 官方 v8 | 我的(第 2999 轮) |
|---|---|---|
| 前进 0.3 m/s,实际速度 | 0.118 m/s | 0.123 m/s |
| 原地转 1.0 rad/s,实际转速 | 0.99 rad/s | 1.02 rad/s |
| 仰面躺着,爬起用时 | 0.62 s | 0.52 s |
| 趴着,爬起用时 | 0.36 s | 0.36 s |
| 爬起和推搡(push),9 类各 40 次,失败次数 | 4 | 4 |
9 类包括仰面、趴着、侧躺,每种再分关节在默认姿势和关节随机两种;还有随机朝向从 12 厘米高处丢下,以及站着和走着时被横向踢一下(0.8 到 1.2 m/s)。两个策略各有 4 次卡住爬不起来,有一个随机朝向的开局两个都过不去。
只有一项明显比官方差:指令 0.15 m/s 时,我的策略站着不动。
为什么慢速不走
我把四个策略在 0.05 到 0.40 m/s 之间扫了一遍,发现它们都有一个死区(dead zone):指令落在死区里就站着,一出死区就直接走到 0.07 到 0.09 m/s,中间没有过渡。我的 velstand 死区边界在 0.15 和 0.20 之间,和官方走路教师策略 alpha_walking 完全一样。
原因有两层。第一层是奖励太宽:前进速度跟踪奖励是 2·exp(−误差²/0.1),指令 0.15 时站着不动也能拿 1.60 分,以 0.08 m/s 起步走是 1.90 分,只多 0.3 分,还要付动作变化、身体晃动、脚打滑的惩罚。第二层是继承:velstand 训练时,倾斜小于 25° 的帧都用行为克隆贴向走路锚点,锚点在 0.15 时的动作就是站着,学生照着学。
Pollen 在转向上踩过同一个坑,他们的修法是给锚点喂放大后的转向指令,再加一项更窄的转向跟踪奖励。前进方向没有做。我照着补上:小指令时喂给锚点放大的速度(0.10 喂 0.22,0.15 喂 0.25),加一项 std 0.12 的窄跟踪奖励,再从第 2999 轮继续训练 1000 轮。
修完的结果
每 250 轮存一个版本。走路每个速度测 10 个随机开局,每次 20 秒;爬起和推搡还是 360 次。
| 版本(version) | 0.15 m/s 能走吗(walks at 0.15 m/s?) | 0.3 m/s 直走偏航(yaw) | 爬起和推搡失败(get-up & push failures) |
|---|---|---|---|
| 官方 v8 | 10 次里 4 次不走 | +0.02 rad/s | 4 / 360 |
| 修之前(第 2999 轮) | 10 次里 9 次不走 | −0.04 rad/s | 4 / 360 |
| 第 3750 轮 | 10 次都走,约 0.07 m/s | −0.26 rad/s | 0 / 360 |
| 第 3998 轮 | 10 次都走,约 0.07 m/s | +0.02 rad/s | 12 / 360 |
0.15 m/s 修好了,比官方还稳。麻烦的是没有一个版本各项都好:第 3998 轮走得直,但有 12 次彻底爬不起来(我用 20 秒窗口重跑过,不是慢,是卡住);第 3750 轮 360 次全爬起来了,但 0.2 到 0.3 m/s 直走时稳定地往右偏,每秒十几度。继续训练过程中,爬起能力在各个版本之间来回晃,看上去慢走和爬起在争同一部分网络。
我选了第 3750 轮。它的偏航很固定,10 个开局的波动只有 ±0.01 rad/s,给一个反向转向指令(0.3 m/s 时加 +0.25 rad/s)就走直了,速度不变。真机换了舵机和背隙,本来就会有自己的偏航,控制层迟早要用 IMU 朝向做闭环修正,所以这个代价我愿意付。爬不起来就没有办法在外面补了。
还剩一个没解决:指令 0.10 m/s 时,所有版本都还是站着。锚点已经被喂了 0.22,原因我还没查清。
训练出的权重(选定的第 3750 轮,加上修之前、第 3998 轮和走路教师策略三个对照版本)、修慢速的补丁和评估脚本,我都放到了 Hugging Face 上:mindthink/microduck-policies-repro。
几点体会
强化学习(reinforcement learning, RL)策略对环境非常挑剔。观测(observation)维度、执行器(actuator)模型、场景里的一个背隙,任何一处跟训练时对不上,策略都可能站得住但不迈步,而且不报任何错。所以排查时,第一步应该是翻出策略的 manifest 和训练任务名对一遍,而不是先猜。我那个 BAM 的猜测(见第三篇)是被对照实验推翻的;要是装上 BAM 碰巧走起来了,我大概就停在一个错误的结论上。
Microduck 的工程质量整体很高,最让我佩服的是”软件和策略分开发布”以及处处可回滚的部署设计,还有那些把”为什么”写清楚的设计文档。仿真里的问题出在一个写死的文件名上:策略集升级了,脚本没跟着改。只要有写死的值,迟早会和数据对不上。
如果你也想动手:一张支持 CUDA 的显卡就能训练,没有机器人也能在仿真里把整套守护进程跑起来。
请我喝杯咖啡