“拆一只开源鸭子”系列:(一)硬件、软件和部署 · (二)训练原理 · (三)仿真里鸭子为什么不走路 · (四)自己训一遍
第一篇《硬件、软件和部署》讲了 Microduck 的身体和机器人上的软件。这一篇讲让它走路、站立、摔倒后爬起来的那个策略(policy)是怎么训练出来的。先补几个概念,熟悉强化学习(reinforcement learning, RL)的读者可以直接跳到“先说结论”。
先补几个概念
- 强化学习。不给机器人写走路的规则,而是让它在仿真(simulation)里反复试。做得好加分,做得差扣分,这个分数叫奖励(reward)。训练就是一点点调整网络的参数,让总分越来越高。
- 策略。训练出来的那个神经网络。它每 20 ms 看一次传感器读数(观测),输出每个关节该转到哪里(动作)。在 Microduck 上,策略就是一个 ONNX 文件。
- 并行仿真和“一轮”。在 GPU 上同时跑 4096 只仿真鸭子,每只走 24 步(每步 20 ms),收集到的数据用来更新一次网络,这叫一轮(iteration)。一轮是 4096 × 24 = 98,304 步,相当于约 33 分钟的仿真时间。训练 4000 轮约 3.9 亿步,相当于一只鸭子连续练了约 91 天。
- PPO 和 Actor-Critic。PPO 是最常用的强化学习算法之一。Actor 是决定动作的网络,也就是最后部署的策略;Critic 给当前状态估一个分,只在训练时用。每一轮,PPO 用 Critic 判断哪些动作比预期好,把 Actor 往那个方向改,同时限制每次改动的幅度,防止一步改坏。
- 行为克隆(behavior cloning, BC)和教师策略(teacher policy)。先单独训练好“教师”策略,再让新网络在同样的情况下直接模仿教师策略的动作。这比强化学习自己摸索快得多。velstand 有两个教师策略:一个只会走路(也叫走路锚点,anchor),一个只会爬起来。模仿学习(imitation learning)的文献里也把这类策略叫专家(expert)。
- 域随机化(domain randomization)和 sim2real。仿真和真机总有差别。训练时让每只仿真鸭子的摩擦、质量、延迟、电池电压都随机一点,策略在这些略有不同的“世界”里都能走,换到真机上成功的机会就大。从仿真搬到真机这一步叫 sim2real。
- 课程学习(curriculum learning)。难度分阶段加。开始时任务简单,策略学会以后再加推搡(push)、加更严的动作平滑惩罚、加站立练习。
- 检查点(checkpoint)。训练中每隔一段(这里是 250 轮)存一次网络参数。最后用哪个检查点要靠评估来挑,不一定是最后一个。第四篇里就遇到了这种情况。
先说结论:一个 20 万参数的小网络
走、站、摔倒后爬起来,Microduck 出厂时都靠同一个策略文件 velstand.onnx。打开它看,里面只有一个很小的多层感知机(MLP):先做一次归一化(normalization),再过三层全连接(512、256、128 个神经元,ELU 激活),最后输出 14 个数。一共约 19.8 万个参数,文件 775 KB。
难的不是网络,而是三件事:给它看什么(观测)、让它输出什么(动作)、用什么标准奖励它(奖励)。下面一项项说。
观测:每 20 ms 给网络看 61 个数
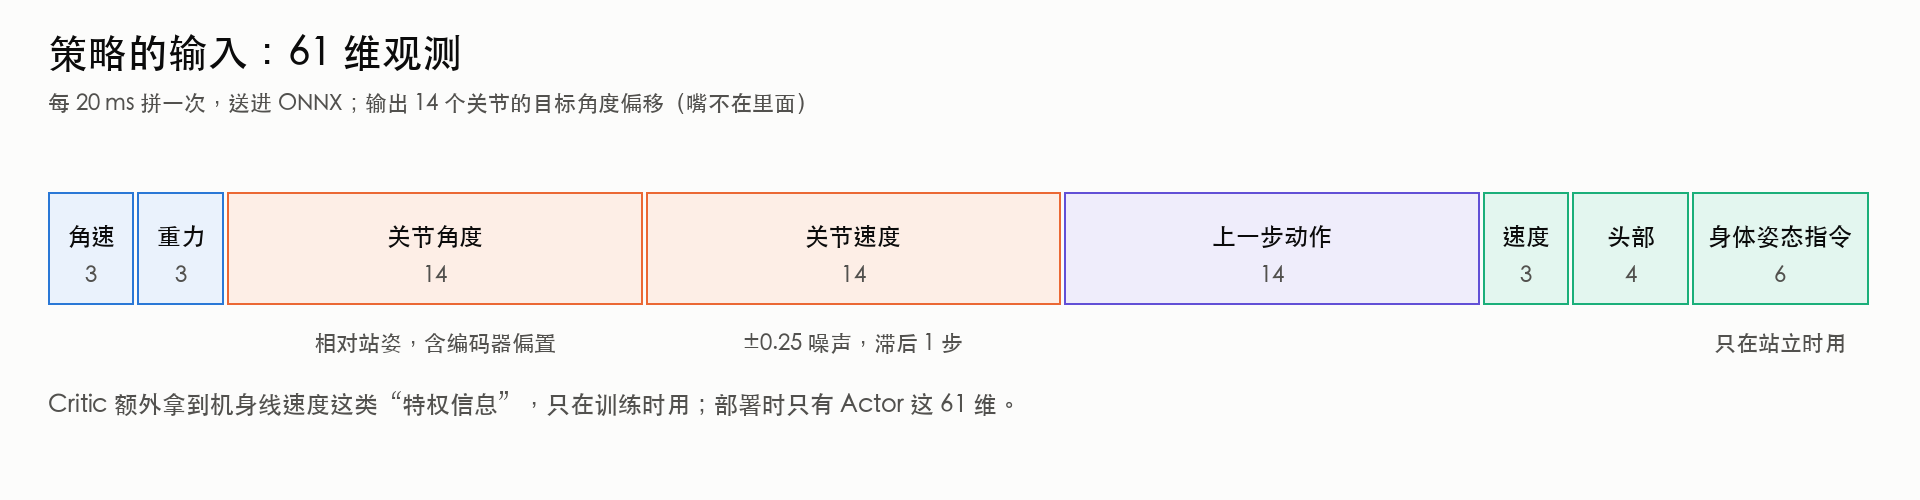
| 位置(index) | 内容(content) | 配置名(config name) | 维数(dims) | 为什么要它(why) |
|---|---|---|---|---|
| 0~2 | 机身角速度(陀螺仪) | base_ang_vel |
3 | 知道自己在往哪边歪、转得多快 |
| 3~5 | 重力方向在机身坐标系里的投影 | projected_gravity |
3 | 知道自己的姿态。比直接给欧拉角稳定,没有角度跳变 |
| 6~19 | 14 个关节角度,减去站姿 | joint_pos |
14 | 以站姿为零点,数值集中在 0 附近,网络好学 |
| 20~33 | 14 个关节速度 | joint_vel |
14 | 判断腿在往哪边动 |
| 34~47 | 上一步自己输出的动作 | actions |
14 | 舵机(servo)有延迟,网络要知道自己”刚才下了什么命令”,才能判断现在关节角度和目标的差距 |
| 48~50 | 速度指令:vx、vy、转向 | command |
3 | 要它往哪走 |
| 51~54 | 头部指令:4 个头颈关节 | head_command |
4 | 头很重,抬头低头会改变重心,所以头的目标交给策略,由它一边动头一边保持平衡 |
| 55~60 | 身体姿态指令:高度、横滚(roll)、俯仰(pitch)等 | body_command |
6 | 只在站立时用,可以让鸭子蹲一点、歪一点 |
几个设计上的取舍值得一说:
- 没有机身线速度。 真机上没有可靠的方法直接测出机身在地面上的速度,所以 Actor(部署的那个网络)看不到它。训练时用的 Critic(只用来打分、不部署)却能看到,这叫”非对称 Actor-Critic(asymmetric actor-critic)”。Critic 有了特权信息,打分更准,训练更稳;部署时又不依赖拿不到的东西。
- 没有步态(gait)相位。 很多双足机器人会给网络一个”时钟”信号,告诉它现在该迈左脚还是右脚。Microduck 的行走策略没有,步态完全靠奖励里的”腾空时间(air time)”逼出来。
- 嘴不在里面。 嘴不影响平衡,交给脚本控制,网络少学一件事。
- 故意加噪声和延迟。 陀螺仪(gyroscope)每个分量加 ±0.03 的噪声,关节速度加 ±0.25 的噪声并且固定滞后一步,IMU 有最多 6° 的安装误差,编码器(encoder)有 ±0.015 rad 的偏置。真机传感器就是这么脏,训练时不脏,上机就会翻车。
- 机器人端不做任何缩放。
robotd直接把物理单位(rad、rad/s)塞进去,归一化在 ONNX 里面做,第一篇的“导出成 ONNX”一节说了为什么。
机器人端拼观测(observation)的代码,开头的注释就是这张表,作者把它称为”这个 crate 里风险最高的代码”:错一个下标不会报错,只会得到一个”看起来正常但会摔倒”的机器人。
// duck-control/src/obs.rs
//! index   width  contents
//! 0..3        3  gyro, trunk frame, rad/s
//! 3..6        3  projected gravity, trunk frame, unit vector
//! 6..20      14  joint position minus home pose, mouth excluded
//! 20..34     14  joint velocity, mouth excluded
//! 34..48     14  previous action, mouth excluded
//! 48..61     13  command (below)
pub const OBS_LEN: usize = 61;
pub const ACTION_LEN: usize = 14;
动作:14 个关节的目标偏移
网络输出 14 个数,含义是”各关节相对站姿的目标偏移”。最后的目标角度 = 站姿 + 缩放系数 × 输出,再交给舵机自己的位置环(P 控制,增益 200)去追。
为什么不直接输出力矩?XL330 是位置舵机,固件里就有位置环,输出目标角度最直接。代价是策略学到的不是”用多大力”,而是”把目标放在哪里”,舵机怎么追这个目标,就得靠后面说的 BAM 舵机模型在仿真里模拟准。
// robotd/src/control.rs
// 14 个输出放回 15 个关节,跳过嘴
let offsets = Observation::scatter_action(&action);
let mut targets = [0.0; NUM_JOINTS];
for joint in 0..NUM_JOINTS {
    targets[joint] = DEFAULT_POSITION[joint] + scale * offsets[joint];
}
奖励:告诉它什么是”走得好”
| 奖励项(reward term) | 配置名(config name) | 权重(weight) | 作用(purpose) |
|---|---|---|---|
| 线速度跟踪 | track_linear_velocity |
2.0 | 跟上 vx、vy 指令 |
| 角速度跟踪 | track_angular_velocity |
2.0 | 跟上转向指令 |
| 精细偏航(yaw)跟踪 | track_yaw_fine |
2.0 | v8 新加的,减少走直线时跑偏 |
| 身体直立 | upright |
2.0 | 躯干保持水平 |
| 腾空时间 | air_time |
3.0 | 每步腾空 0.125~0.3 s 才给分,逼它真正迈步,而不是拖着脚蹭 |
| 头部姿态跟踪 | head_pose_tracking |
2.0 | 头跟上指令 |
| 爬起进度(高度) | height_progress |
30.0 | 摔倒后每往上抬一点就给奖励 |
| 爬起成功 | recovery_success |
+10 | 一次性奖励 |
| 动作变化率 | action_rate_l2 |
−1.0 | 动作平滑,不抖 |
| 自碰撞 | self_collisions |
−1.0 | 腿别打到身体 |
| 落地冲击 | servo_impact、head_impact、trunk_impact |
−0.01 ~ −0.02 / N | 摔倒时别硬着陆 |
| 舵机堵转 | servo_stall |
−0.05 | 低速大力矩时惩罚,保护齿轮 |
正的是”做到了给分”,负的是”做了扣分”。爬起相关的权重特别大,因为”从地上爬起来”这件事本身很难碰巧做到,奖励给得少,网络根本学不会。
“腾空时间”是逼出步态的那一项。注释里还提到一个细节:零指令时原地站着不动,不是靠专门的”别迈步”惩罚教会的,而是让 25% 的环境练站立:
# microduck_rl/.../tasks/microduck_velocity_env_cfg.py
# air_time window [0.125, 0.300] s. NOTE: standing still at zero
# command is taught by the standing_envs curriculum (→25% standing
# envs by ~iter 2000), not by an explicit stillness/no-stepping term.
cfg.rewards["air_time"].weight = 3.0
cfg.rewards["air_time"].params["threshold_min"] = 0.125
cfg.rewards["air_time"].params["threshold_max"] = 0.300
指令范围也是调出来的。原来给的转向范围是 ±2.0 rad/s,超出了这只鸭子的能力,训练到后期反而越来越差,改成 ±1.0 才学会转向:
# lin ±0.4 / ang ±2.0 outpaced the robot's capability and tracked a
# post-iter-1000 reward/episode-length decline. ang ±1.0 is the big
# change — it makes turning learnable.
command.ranges.lin_vel_x = (-0.4, 0.4)
command.ranges.lin_vel_y = (-0.3, 0.3)
command.ranges.ang_vel_z = (-1.0, 1.0)
随机化:让仿真”不准”得刚刚好
仿真永远和真机不一样。与其把仿真调得完全准确,不如每个环境都随机一点,逼策略在一大片”差不多”的世界里都能走:
| 项目(item) | 配置名(config name) | 范围(range) |
|---|---|---|
| 脚底摩擦 | foot_friction |
0.7~1.3 |
| 躯干质心(center of mass, CoM)偏移 | randomize_com |
最多 ±15 mm |
| 躯干质量和惯量(inertia) | randomize_mass_inertia |
±5% |
| 电池电压 | BAM vin_range、vin_drop_gain_range、vin_min |
6.5~8.2 V,带负载压降,最低 6.0 V |
| 舵机指令延迟 | BAM delay_min_lag、delay_max_lag |
3~6 个仿真步(推算 15~30 ms) |
| 行走时推搡 | push_robot |
±0.3 m/s,每 3~6 秒一次 |
| 背隙(backlash) | passive_* 被动关节(scene_backlash.xml) |
±1° |
| 初始状态 | random_prone_init(prone_prob、crouch_prob、sit_prob) |
最多 45% 的环境从趴着开始,20% 蹲着,5% 坐着 |
其中最关键的是舵机模型。训练用的是 BAM(Better Actuator Models),用真实 XL330 的台架数据拟合,分三段模拟:固件的 P 控制把位置误差变成电压,直流电机模型(带反电动势)把电压变成力矩,再加上一组摩擦。电池电压也进了这个模型,电压低了力矩就小。README 里有句话:执行器(actuator)的保真度,就是 sim2real 差距的大头。
# microduck_rl/.../robot/microduck_constants.py
_BAM_ACTUATOR_KWARGS = dict(
    motor_name="xl330",
    model="m6",
    # 带 passive_ 前缀的背隙关节不加电机
    target_names_expr=(r"^(?!passive_).*",),
    kp_fw=200.0,
    vin_range=(6.5, 8.2),          # 电池电压随机化
    vin_drop_gain_range=(0.0, 0.2),
    vin_min=6.0,
    delay_min_lag=3,               # 指令延迟 3~6 个仿真步
    delay_max_lag=6,
)
背隙的模拟方法也很巧:每个舵机后面串一个 ±1° 的被动关节,编码器读的是间隙后面的角度,和真实的减速箱一样。
训练过程:PPO 加行为克隆
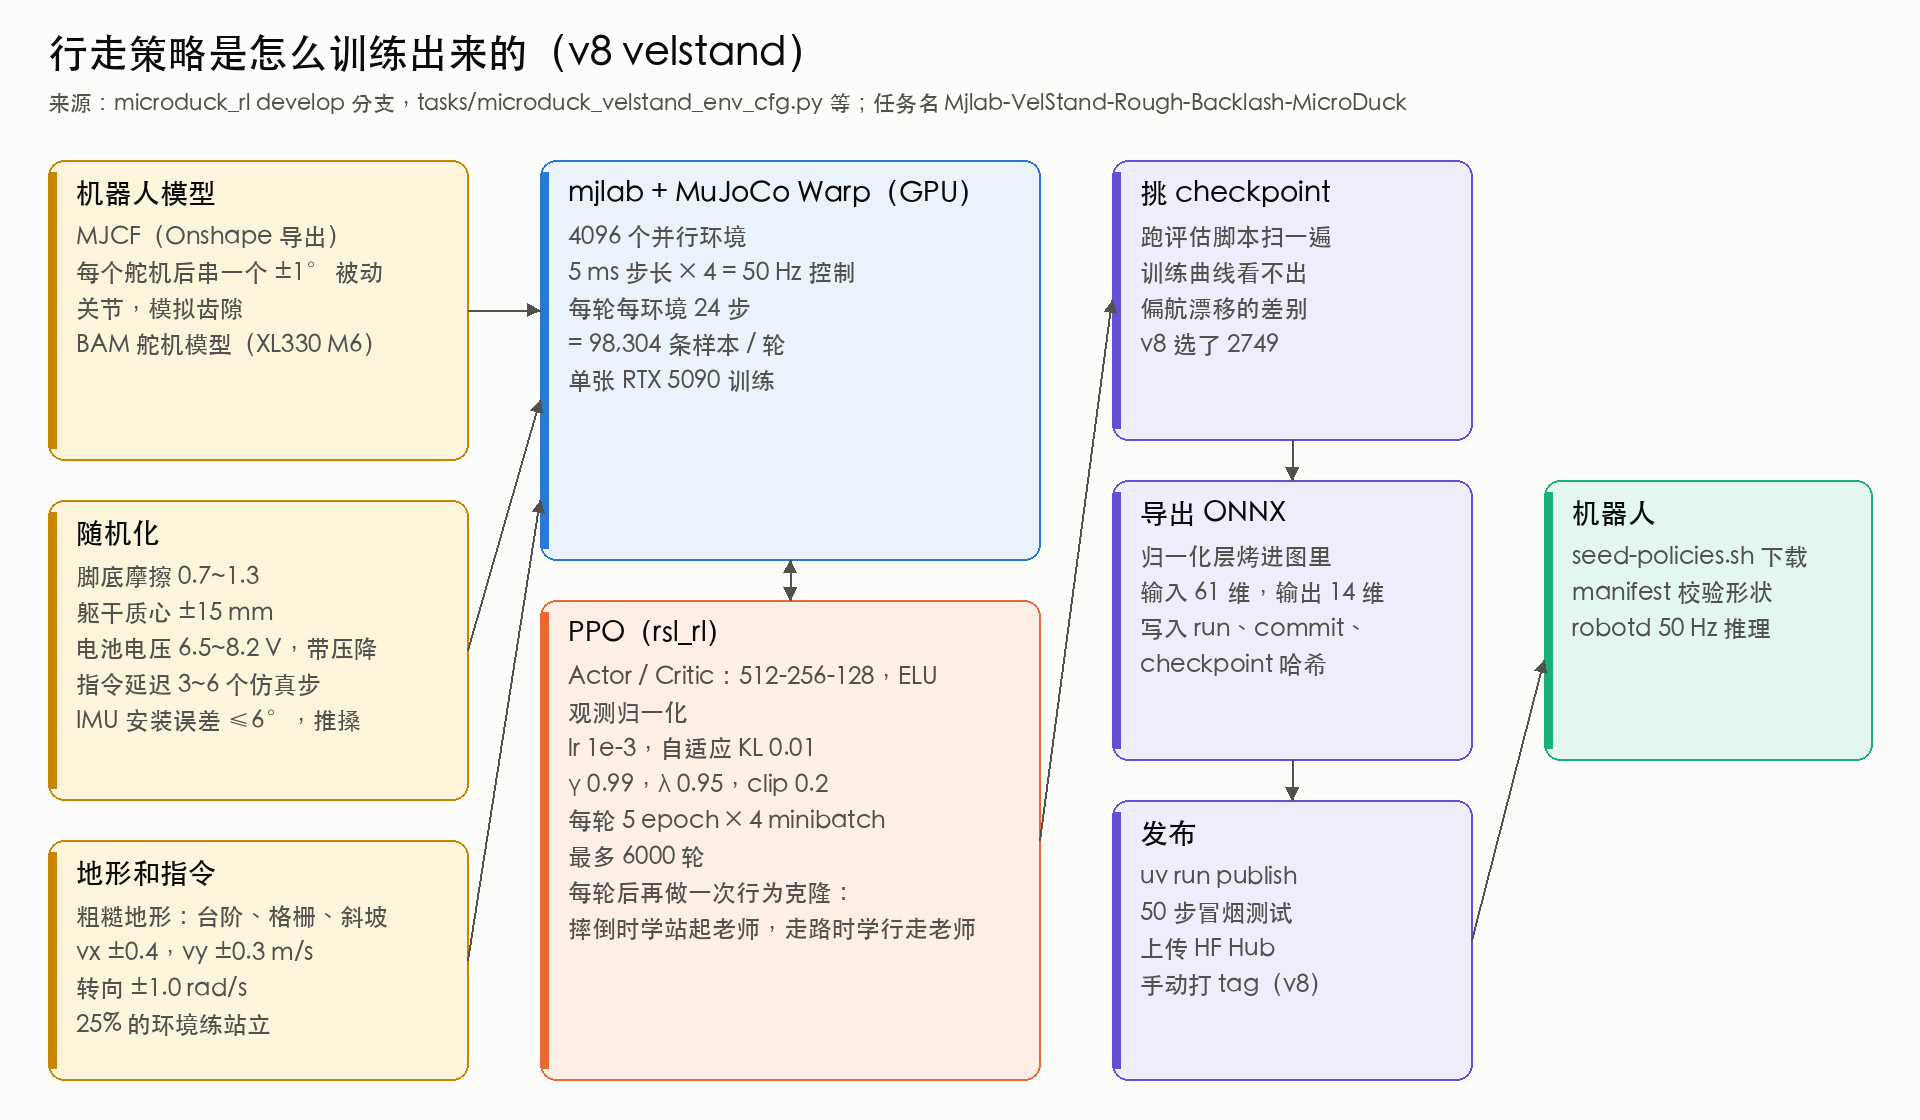
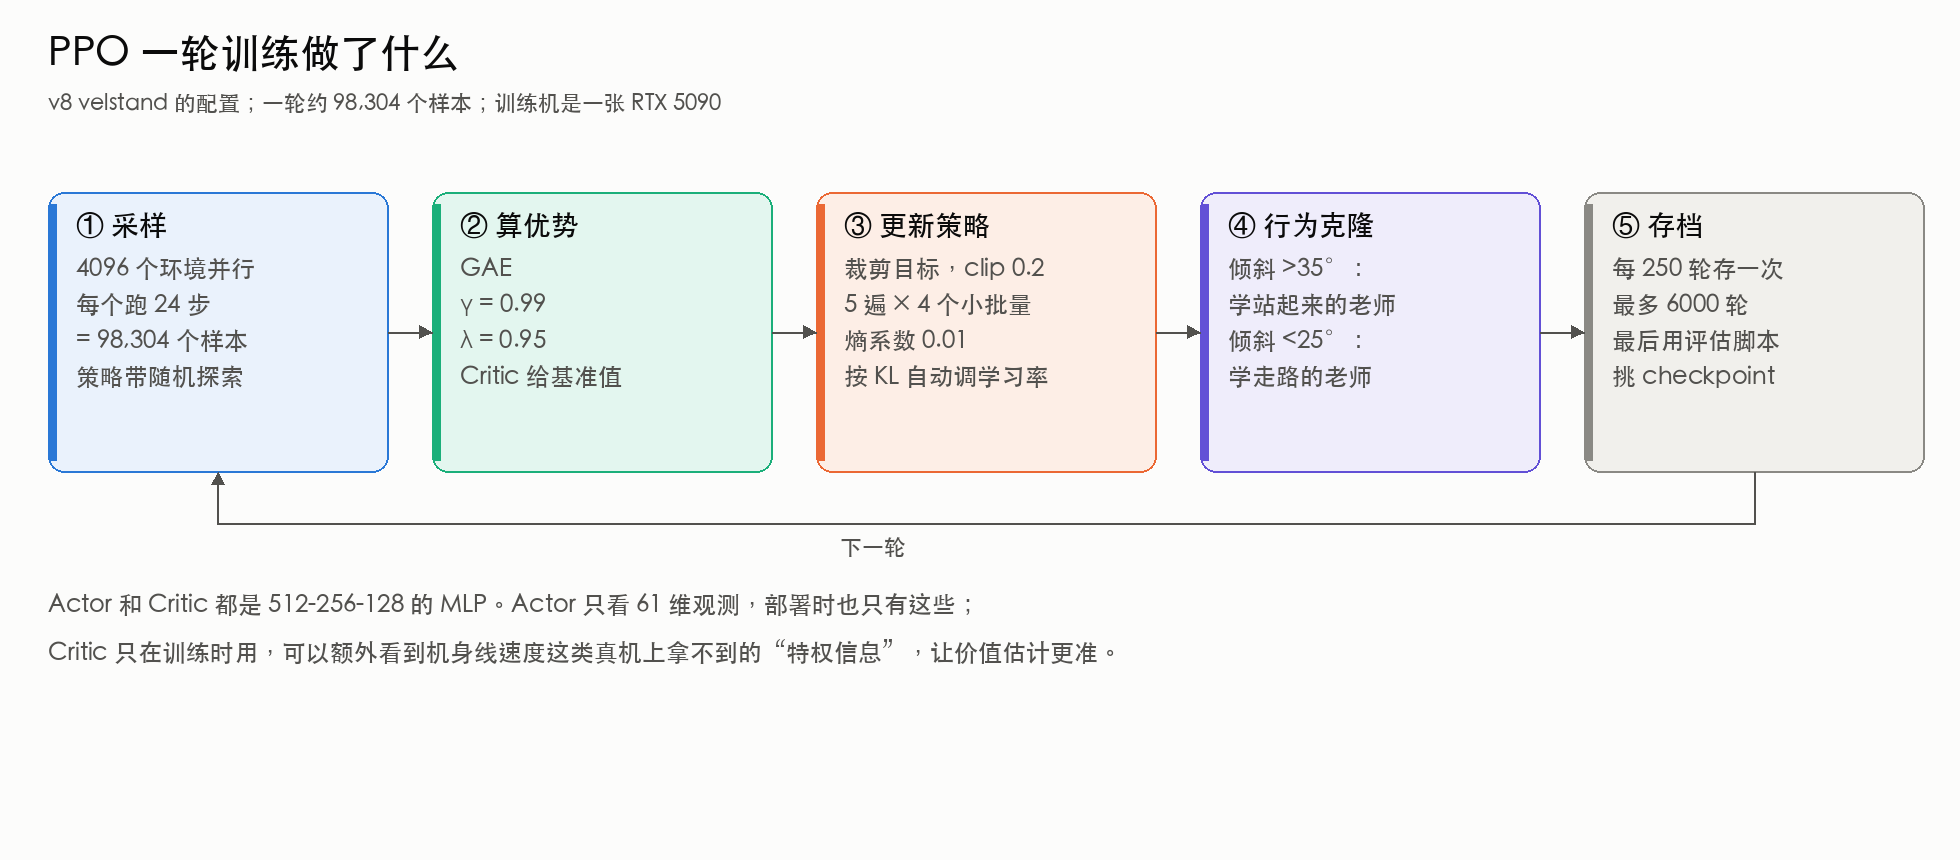
训练框架是 mjlab(MuJoCo Warp,物理仿真跑在 GPU 上)加 rsl_rl 的 PPO。仿真步长 5 ms,每 4 步做一次决策,正好 50 Hz,和机器人的控制循环(control loop)一致。
一轮训练分几步:4096 个环境各跑 24 步收集样本;用 GAE 算出每一步”比预期好多少”(优势);用 PPO 的裁剪目标更新 Actor,每批数据过 5 遍(epoch)、分 4 个小批量(mini-batch),学习率(learning rate)按 KL 散度(KL divergence)自动调整,防止一次改得太猛;最后再做一次行为克隆。
行为克隆是 velstand 能”一个网络干三件事”的关键。它有两个冻结的教师策略:一个只会走路,一个只会爬起来。每轮 PPO 之后,按机身倾斜角度挑一个教师策略来模仿:倾斜超过 35°(多半是摔了)学爬起来,低于 25° 学走路。这样网络不用从零探索怎么爬起来,强化学习只负责把两种能力缝在一起,再优化细节。
PPO 的配置和两个教师策略的阈值,都在训练仓库里:
# microduck_rl/.../tasks/microduck_velstand_env_cfg.py
MicroduckVelStandRlCfg = RslRlOnPolicyRunnerCfg(
    actor=RslRlModelCfg(
        hidden_dims=(512, 256, 128),
        activation="elu",
        obs_normalization=True,
        ...
    ),
    critic=RslRlModelCfg(
        hidden_dims=(512, 256, 128),
        activation="elu",
        obs_normalization=True,
    ),
    algorithm=PpoWithExpertBcCfg(
        clip_param=0.2, entropy_coef=0.01,
        num_learning_epochs=5, num_mini_batches=4,
        learning_rate=1.0e-3, schedule="adaptive", desired_kl=0.01,
        gamma=0.99, lam=0.95,
        bc_cfg={...},              # 行为克隆,见下
    ),
    num_steps_per_env=24,
    max_iterations=6_000,
)

# microduck_rl/.../tasks/distill.py
# stand expert teaches frames with tilt > this
"gate_tilt_deg": 35.0,
# the warm-start walk teaches frames with tilt < this
"anchor_tilt_deg": 25.0,
# dedicated Adam (PPO's adaptive-KL LR must not throttle the BC)
"learning_rate": 3e-4,
注意行为克隆用的是单独的优化器(optimizer):PPO 的学习率会按 KL 自动调小,如果共用,模仿教师策略这一步也会被一起拖慢。
出厂策略是一代代练出来的
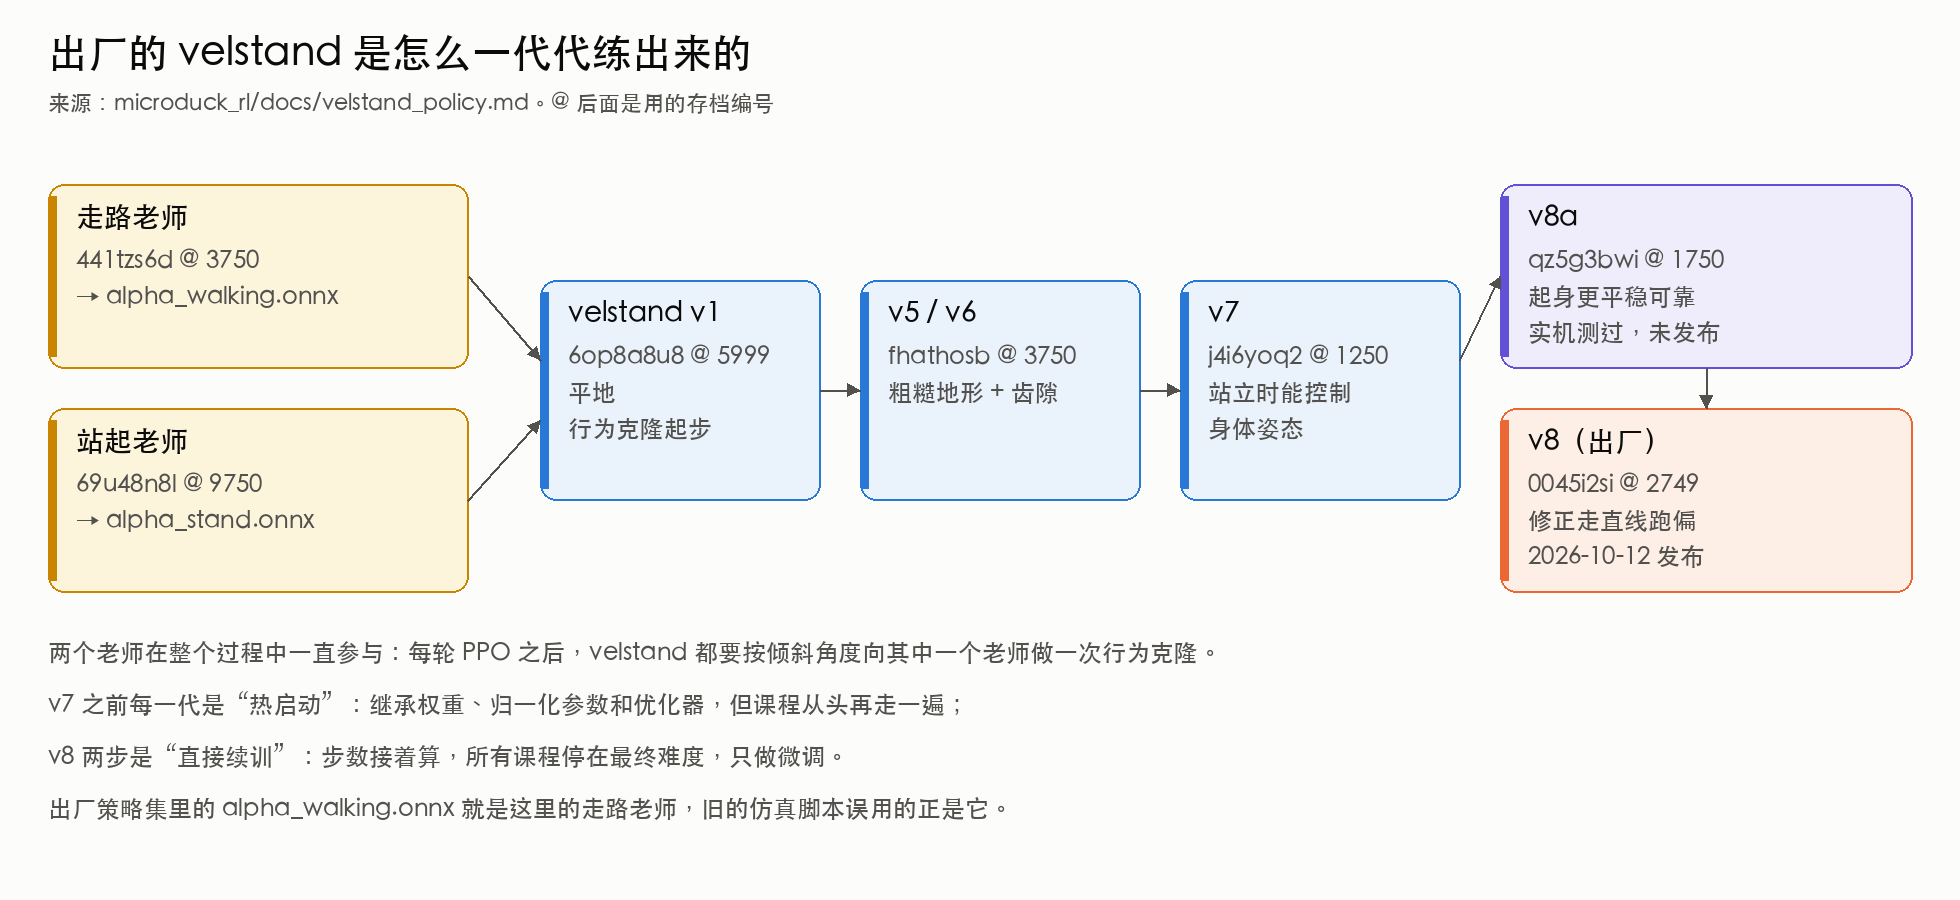
出厂的 v8 不是从零练的。两个教师策略先各自练好,velstand v1 在平地上靠行为克隆起步,之后每一代在上一代基础上加新本事:v5/v6 加粗糙地形和背隙,v7 加站立时的身体姿态控制,v8 先改进起身,再修正走直线跑偏。用的存档要靠评估脚本扫一遍挑出来:训练曲线上看着差不多的两个存档,走直线时一个往左偏、一个往右偏。
官方自己记录的短板
docs/velstand_policy.md 里的基准测试很坦诚:指令 0.4 m/s 时实际只能走到 0.17 m/s;原地慢转(0.3 rad/s)不太跟得上;身体高度(蹲下)没学会。
下一篇《仿真里鸭子为什么不走路》记录我在本地把仿真跑起来以后遇到的问题;第四篇《自己训一遍》是我按上面的配方自己训练的过程和结果。
请我喝杯咖啡